
Trouver une recette, l'horaire d'un musée, la définition d'un mot ou l'adresse d'un artisan : pour la plupart d'entre nous, tout commence par quelques mots tapés dans une barre de recherche. Derrière ce geste devenu réflexe se cache un moteur de recherche, un service capable de retrouver en une fraction de seconde, parmi des milliards de pages publiées sur le Web, celles qui répondent le mieux à une question. Pour y parvenir, il doit explorer en permanence Internet, mémoriser le contenu des pages dans un gigantesque index, puis les classer à chaque requête selon des critères de pertinence tenus en grande partie secrets. Les moteurs de recherche sont ainsi devenus les principaux aiguilleurs du Web : ils décident, de fait, quels sites seront vus et lesquels resteront dans l'ombre, ce qui a donné naissance à tout un métier, le référencement. Leur histoire, commencée au début des années 1990, a vu se succéder de nombreux acteurs, des pionniers oubliés aux géants actuels, en passant par des alternatives soucieuses de la vie privée ou de l'environnement. Cette définition explique ce qu'est un moteur de recherche, comment il fonctionne, comment il a évolué et en quoi il se distingue d'un métamoteur.
Qu'est-ce qu'un moteur de recherche ? Définition
Un moteur de recherche est un service en ligne qui permet de retrouver des informations sur Internet à partir de mots-clés ou de questions formulées par l'utilisateur, appelées requêtes. Il repose sur trois composants : des robots d'exploration qui parcourent le Web, un index qui stocke et organise ce qu'ils découvrent, et des algorithmes de classement qui déterminent l'ordre d'affichage des résultats. Pour évaluer l'intérêt d'une page, ces algorithmes combinent de très nombreux signaux : la présence et la place des mots recherchés, la qualité et l'originalité du contenu, la fraîcheur de l'information, l'expérience offerte au visiteur, ou encore la réputation du site, mesurée notamment par les liens que d'autres sites lui consacrent, appelés backlinks. Le résultat de ce travail s'affiche sur une page de résultats, la SERP, qui présente généralement une liste de liens accompagnés d'un titre et d'un court extrait, complétée selon les cas par des images, des vidéos, des cartes ou des réponses directes. La plupart des moteurs sont gratuits pour l'internaute et se financent par la publicité affichée à côté des résultats naturels.
Moteur de recherche, annuaire, navigateur : ne pas confondre
Plusieurs notions voisines du moteur de recherche sont souvent mélangées. Le navigateur est le logiciel installé sur l'ordinateur ou le téléphone qui permet d'afficher les pages web, comme Chrome, Firefox, Safari ou Edge ; il intègre une barre de recherche qui transmet les mots tapés à un moteur choisi par défaut, mais il n'est pas lui-même un moteur. L'annuaire web, très répandu dans les années 1990, est une autre approche : des rédacteurs humains y classent les sites dans des catégories et sous-catégories, comme dans un annuaire téléphonique, sans explorer automatiquement le contenu des pages. Yahoo! fut à ses débuts l'annuaire le plus célèbre, avant de se convertir à la recherche automatique. Il faut aussi distinguer le moteur généraliste, qui couvre l'ensemble du Web, des moteurs spécialisés, qui se concentrent sur un type de contenu : les offres d'emploi, les billets d'avion, les articles scientifiques, les produits d'une boutique ou les documents internes d'une entreprise. Enfin, les assistants vocaux et les agents conversationnels s'appuient souvent sur un moteur de recherche pour répondre, mais reformulent l'information au lieu de proposer une liste de liens.
Quelle est l'histoire des moteurs de recherche ?
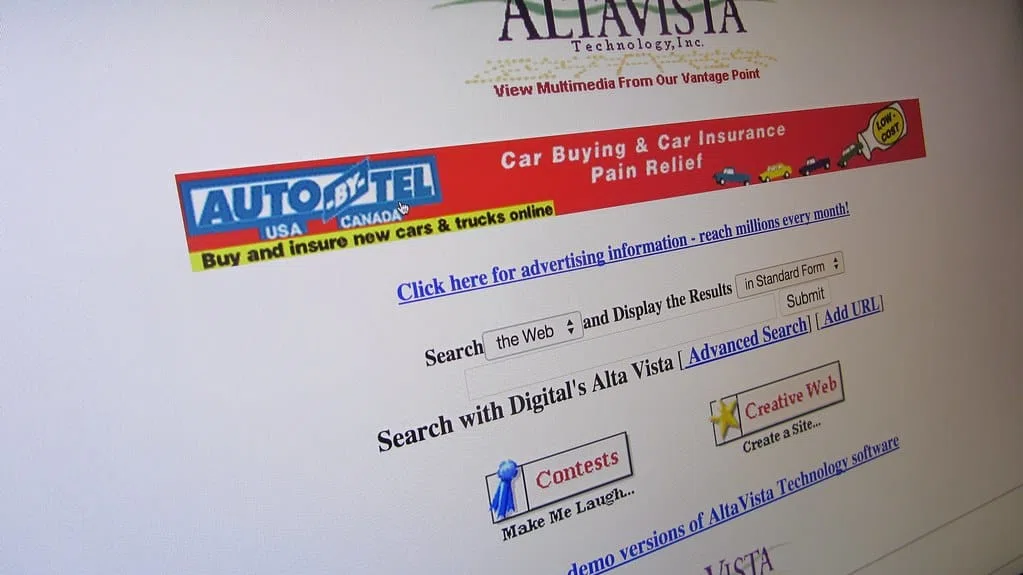
L'histoire des moteurs de recherche commence avant même le Web. En 1990, l'étudiant canadien Alan Emtage crée Archie, un outil qui recense les fichiers disponibles sur des serveurs FTP publics, des ordinateurs où l'on venait télécharger des logiciels et des documents. Il est suivi de Veronica et Jughead, qui explorent le réseau Gopher, un système de menus alors concurrent du Web. En 1993, Matthew Gray met au point le World Wide Web Wanderer, l'un des premiers robots à parcourir le Web pour en mesurer la taille, tandis qu'Aliweb permet aux webmestres de déclarer eux-mêmes leurs pages. L'année 1994 voit naître Yahoo!, d'abord annuaire, ainsi que WebCrawler, premier moteur à indexer le texte intégral des pages, et Lycos. Fin 1995, AltaVista impressionne par la taille de son index et la rapidité de ses réponses, et devient pour quelques années la référence des internautes. Cette période foisonnante, où chaque portail rivalise d'actualités, de météo et de services sur sa page d'accueil, se caractérise aussi par des résultats faciles à manipuler : il suffisait souvent de répéter un mot-clé sur une page pour la faire remonter dans les classements.
De Google aux moteurs alternatifs
En septembre 1998, Larry Page et Sergey Brin fondent officiellement Google, issu de leurs recherches à l'université Stanford. Leur moteur de recherche se distingue par une idée simple et puissante : juger l'importance d'une page d'après les liens qui pointent vers elle, grâce à l'algorithme PageRank, et proposer une page d'accueil dépouillée, centrée sur la seule recherche. En quelques années, Google supplante ses concurrents et s'impose dans la plupart des pays. D'autres acteurs conservent toutefois une place importante. Baidu, fondé en 2000, domine la recherche en langue chinoise ; Yandex occupe historiquement une position forte en Russie ; Microsoft lance Bing en 2009, après plusieurs tentatives sous d'autres noms. Une nouvelle génération de moteurs mise ensuite sur des valeurs différentes : DuckDuckGo, créé en 2008, promet de ne pas profiler ses utilisateurs ; le français Qwant, lancé en 2013, revendique lui aussi le respect de la vie privée ; l'allemand Ecosia, apparu en 2009, consacre une part de ses bénéfices à la plantation d'arbres. Ces alternatives s'appuient souvent, en partie, sur l'index d'un grand moteur, tout en construisant leurs propres outils.
Comment fonctionne un moteur de recherche ? Exploration, index et classement
Le travail d'un moteur de recherche commence bien avant que vous tapiez votre requête. Des programmes automatiques, appelés robots, crawlers ou spiders (« araignées », en référence à la toile du Web), visitent sans relâche les pages web. Sur chaque page, ils lisent le texte, notent les images et les métadonnées, puis suivent les liens pour découvrir de nouvelles pages, et ainsi de suite. Les propriétaires de sites peuvent les guider grâce à un plan du site ou leur interdire l'accès à certaines zones grâce à un petit fichier nommé robots.txt. Les informations récoltées sont ensuite analysées et rangées dans l'index, une base de données gigantesque organisée un peu comme l'index alphabétique d'un livre : pour chaque mot, elle sait quelles pages le contiennent et à quel endroit. Cette organisation permet de répondre en une fraction de seconde au lieu de relire tout le Web à chaque question. L'index est mis à jour en continu, car des pages naissent, changent ou disparaissent à chaque instant ; les sites d'actualité très actifs sont visités plusieurs fois par jour, alors qu'une page rarement modifiée peut n'être revue qu'à intervalles plus espacés.
Du mot-clé à l'intention : le classement des résultats
Quand l'internaute lance sa requête, le moteur de recherche sélectionne dans son index les pages susceptibles de convenir, puis les classe. Les premiers moteurs se contentaient de compter les occurrences des mots demandés. Les moteurs actuels cherchent surtout à comprendre l'intention de recherche : la personne qui tape « avocat » veut-elle une recette, un conseil juridique ou l'adresse d'un cabinet ? Grâce au traitement automatique du langage et à l'intelligence artificielle, ils analysent le sens global de la phrase, reconnaissent les synonymes, les fautes de frappe et les entités (personnes, lieux, œuvres), et tiennent compte du contexte, comme la langue ou la localisation de l'utilisateur. On parle de recherche sémantique. Le classement combine ensuite des centaines de critères, dont la pertinence du contenu, sa fiabilité, l'expertise de son auteur, la qualité technique de la page, sa vitesse et son confort de lecture sur mobile. Ces algorithmes sont régulièrement modifiés, parfois profondément, pour améliorer la qualité des résultats et déjouer les manipulations, ce qui peut faire varier brusquement la visibilité d'un site d'un jour à l'autre.
Qu'est-ce que la SERP d'un moteur de recherche ?
La SERP, pour Search Engine Results Page, désigne la page de résultats affichée par un moteur de recherche en réponse à une requête. À ses débuts, elle se résumait à une liste de dix liens bleus accompagnés d'un court extrait. Elle est aujourd'hui beaucoup plus riche et varie fortement selon la question posée. On y trouve les résultats naturels, classés par l'algorithme, et des annonces publicitaires, signalées comme sponsorisées, placées en haut ou en bas de page. S'y ajoutent selon les cas des encadrés de réponse directe, qui citent un passage d'une page répondant à la question, des fiches de connaissances sur une personnalité ou un lieu, une carte avec les commerces proches, des carrousels d'images, de vidéos ou d'actualités, des questions associées, des avis, des prix, et désormais des résumés rédigés par intelligence artificielle. Cette évolution permet souvent d'obtenir une réponse sans cliquer sur aucun lien, ce qui profite à l'internaute pressé mais réduit les visites envoyées aux sites. Les éditeurs peuvent aider les moteurs à mieux présenter leurs pages en ajoutant des données structurées, des informations codées qui décrivent précisément une recette, un produit ou un événement.
Moteur de recherche ou métamoteur : quelle différence ?
Un moteur de recherche au sens strict, comme Google ou Bing, possède ses propres robots et son propre index, et classe les pages selon ses propres algorithmes. Un métamoteur, lui, n'explore pas le Web : il transmet la requête de l'utilisateur à plusieurs moteurs, récupère leurs réponses, élimine les doublons et les fusionne en une seule liste. Dogpile ou MetaCrawler sont des exemples historiques de ce modèle, qui offre une vision plus large et peut faire apparaître des pages mal placées dans un moteur donné. En contrepartie, le métamoteur dépend entièrement de ses sources et ne peut rivaliser avec leurs fonctions avancées. Entre ces deux modèles, de nombreux moteurs alternatifs adoptent une solution mixte : ils achètent l'accès aux résultats d'un grand moteur, les complètent par leurs propres données et les présentent dans leur interface, en appliquant leurs propres règles en matière de publicité et de vie privée. Le tableau ci-dessous présente quelques moteurs connus et leur positionnement général, sachant que leurs partenariats techniques évoluent régulièrement.
| Moteur | Origine | Positionnement |
|---|---|---|
| États-Unis, 1998 | Moteur généraliste dominant dans la plupart des pays | |
| Bing | États-Unis (Microsoft), 2009 | Moteur généraliste, fournit aussi des résultats à d'autres services |
| Baidu | Chine, 2000 | Recherche en langue chinoise |
| DuckDuckGo | États-Unis, 2008 | Absence de profilage publicitaire |
| Qwant | France, 2013 | Respect de la vie privée, ancrage européen |
| Ecosia | Allemagne, 2009 | Bénéfices consacrés en partie à la reforestation |
| Dogpile | États-Unis, années 1990 | Métamoteur agrégeant plusieurs moteurs |
Comment bien utiliser un moteur de recherche et y être visible ?
Quelques astuces suffisent pour tirer un meilleur parti d'un moteur de recherche. Placer une expression entre guillemets oblige le moteur à chercher ces mots exacts dans cet ordre, utile pour retrouver une citation. Le signe moins placé devant un mot exclut les pages qui le contiennent, par exemple pour chercher « jaguar -voiture » quand on s'intéresse à l'animal. Les principaux moteurs acceptent aussi des opérateurs de recherche comme « site: », qui limite la recherche à un site précis, ou « filetype: », qui cible un type de document, comme un PDF. Formuler sa question en langage naturel donne souvent de bons résultats, mais il reste prudent de varier ses sources, de vérifier la date et l'auteur d'une information et de garder à l'esprit que les premiers liens ne sont pas forcément les plus fiables, ni toujours neutres. Les réglages de confidentialité, disponibles chez la plupart des moteurs, permettent par ailleurs de limiter l'historique conservé et la personnalisation des résultats. Choisir un moteur respectueux de la vie privée ou une navigation privée constitue une autre option pour ceux qui ne souhaitent pas laisser de traces de leurs recherches.
Référencement naturel et référencement payant
Pour les entreprises, les associations ou les médias, apparaître en bonne place sur un moteur de recherche est devenu un enjeu majeur, car la grande majorité des clics se concentrent sur les premiers résultats. Deux voies complémentaires existent. Le référencement naturel, ou SEO (Search Engine Optimization), consiste à rendre un site plus facile à explorer et plus utile aux yeux des algorithmes : contenus de qualité répondant précisément aux questions des internautes, structure claire, pages rapides et adaptées au mobile, liens reçus d'autres sites reconnus. Ses effets sont durables mais demandent du temps et de la régularité, sans garantie de position. Le référencement payant repose au contraire sur l'achat d'annonces affichées en tête ou en bas des résultats pour des mots-clés choisis, avec un paiement le plus souvent déclenché à chaque clic. Il offre une visibilité immédiate et mesurable, mais qui s'arrête dès que le budget est épuisé. Les deux approches sont souvent combinées, l'une pour construire une présence de fond, l'autre pour une opération ponctuelle ou un lancement. Pour comprendre le fonctionnement des campagnes publicitaires sur les moteurs, on pourra consulter notre définition du SEA.